Estimados amigos de Inseguros !!!
Hoy toca hablar de RAG, una de esas siglas que lleva meses en todas las presentaciones de IA y que, como casi siempre, es bastante más sencilla de lo que parece.
Te pongo en situación. Tienes varios agentes de IA trabajando: uno en tu terminal, otro programando, otro en el escritorio… Y ninguno sabe nada de lo tuyo. Ni tus procedimientos, ni tus informes, ni cómo hacéis las cosas en tu empresa.
Les preguntas por tu procedimiento de respuesta a incidentes y te contestan con uno genérico de manual. Correcto, bonito… y que no es el tuyo.
Esta es una serie de dos entradas. En esta voy con los conceptos: qué es un RAG, en qué se diferencia del fine-tuning y por qué tiene sentido montarlo como un servicio compartido para todos tus agentes. En la segunda, el laboratorio.
Qué es un RAG: «entrenar» sin entrenar
RAG viene de Retrieval-Augmented Generation. Traducido a cristiano: generar una respuesta ayudándose de lo que se recupera de tus documentos.
La idea es esta. Un modelo de lenguaje sabe mucho de todo, pero no sabe nada de tu empresa. Y no lo va a saber, porque tus procedimientos nunca estuvieron en internet cuando lo entrenaron… o eso esperamos 🙂
Con un RAG, cuando alguien hace una pregunta, primero se buscan en tus documentos los trozos que tienen que ver con ella. Después se le pasan al modelo junto a la pregunta, con una instrucción del tipo: «responde usando esto».
¿Has hecho alguna vez un examen con apuntes? Pues eso es un RAG.
El alumno no se ha aprendido el temario. Pero tiene los apuntes encima de la mesa, sabe buscar la página que toca y redacta la respuesta con lo que lee. Desde fuera parece que lo sabe. Por dentro, está leyendo.
Por eso digo que es como «entrenar» el modelo sin entrenarlo. El resultado se parece mucho a tener un modelo que conoce tu empresa, pero el modelo no ha cambiado ni un byte. Lo que cambia es lo que le pones delante en cada pregunta.
Ejemplos reales: dónde encaja un RAG
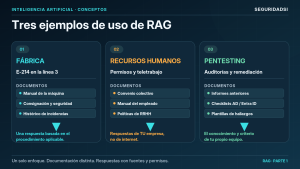
Donde mejor se entiende es con casos de empresa. Te pongo tres muy distintos.
En una fábrica
Un operario de turno de noche tiene la línea 3 parada con una alarma E-214. El técnico de mantenimiento no está y el manual de la máquina son 400 páginas en un PDF que nadie encuentra.
Con un RAG que tenga indexados los manuales de las máquinas, los procedimientos de bloqueo y consignación y el histórico de incidencias, el operario pregunta: «la línea 3 da la alarma E-214, ¿qué hago?».
Y la respuesta no es una idea general sobre alarmas. Es: «según el manual de la envasadora, apartado 7.3, la E-214 es sobretemperatura del motor; antes de abrir el cuadro aplica el procedimiento de consignación; en el histórico, las dos últimas veces fue el ventilador del variador». Con la fuente citada, para que pueda comprobarlo.
En Recursos Humanos
«¿Cuántos días tengo por mudanza?», «¿cómo pido el teletrabajo de los viernes?», «¿qué dice el convenio de las horas extra?».
Son preguntas que RRHH contesta cien veces al mes. Con el convenio colectivo, el manual del empleado y las políticas internas en un RAG, un asistente responde con lo que dice vuestro convenio y vuestra política, no con la normativa general que se encuentra en internet.
Y aquí aparece algo importante, que retomaré luego: ese RAG tiene el convenio, pero no tiene las nóminas. No todo lo que hay en RRHH debe poder recuperarlo cualquiera.
En un equipo de pentesting
Este es el mío. Llevas años de informes de auditoría, una metodología propia, checklists de Active Directory, plantillas de hallazgos redactados a tu manera…
Con todo eso en un RAG, tu agente puede contestarte cosas como: «¿cómo redactamos el hallazgo de LAPS sin desplegar la última vez?», «¿qué comprobamos siempre en un Entra ID antes de empezar?» o «dame el texto de remediación que usamos para el SMB signing».
El agente redacta con tu estilo y tu criterio, porque está leyendo tus propios informes. Eso un modelo genérico no te lo da nunca.
Eso sí… con datos de clientes, cada cliente en su colección y con acceso separado. Lo vemos en la parte de seguridad.
¿Por qué usar un RAG?
Si lo resumo en lo que me importa a mí:
- Tu conocimiento cambia, y el RAG también. Actualizas un procedimiento, lo reindexas y a los cinco minutos ya se usa. Sin reentrenar nada.
- Cita la fuente. Puedes comprobar de qué documento sale cada respuesta. En auditoría o en una fábrica, esto no es un detalle, es obligatorio.
- Menos inventos. El modelo responde apoyándose en texto real, no en lo que «cree recordar». No elimina las alucinaciones, pero las reduce mucho, y además puedes pedirle que diga «no lo encuentro» en lugar de inventar.
- Tus datos no entran en el modelo. Están en tu base de datos. Si un documento sobra, lo borras del índice y desaparece. Con un modelo reentrenado, eso no se puede hacer.
- Control de acceso. Puedes decidir qué documentos ve cada agente o cada usuario.
- Vale para cualquier modelo. Cambias de modelo mañana y tu conocimiento sigue ahí.
- Es barato. No hace falta una granja de GPU. Lo que monto en la segunda entrada corre en un Mac mini.
Entonces, ¿por qué no hacerlo todo con RAG? Porque hay cosas que no se arreglan leyendo apuntes. Y eso nos lleva al fine-tuning.
RAG vs fine-tuning: ¿reentrenar o consultar?
Cuando alguien quiere que un modelo «sepa» cosas de su empresa, la primera idea suele ser reentrenarlo. Eso es el fine-tuning: coges un modelo y lo sigues entrenando con tus datos para que los aprenda de verdad.
Vuelvo al alumno. El fine-tuning es mandarlo seis meses a un máster sobre tu empresa. Vuelve sabiendo mucho, pero lo que cambió ayer no lo sabe, y si se equivoca no hay forma de saber de dónde lo sacó. El RAG es dejarle hacer el examen con los apuntes actualizados encima de la mesa.
| Fine-tuning | RAG | |
|---|---|---|
| Qué hace | Cambia el modelo | Le da contexto al responder |
| Actualizar el conocimiento | Reentrenar | Reindexar un documento |
| Coste | Alto (GPU, datos preparados) | Bajo |
| ¿Cita la fuente? | No | Sí |
| Fuga de datos | Los datos quedan «dentro» del modelo | Controlas qué ve cada agente |
| Cuándo usarlo | Cambiar estilo, formato o comportamiento | Conocimiento que cambia y hay que citar |
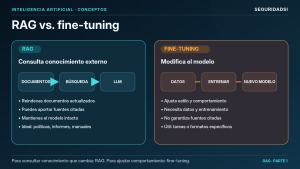
Para el 90 % de los casos de empresa (procedimientos, normativa, documentación interna) la respuesta es RAG. El fine-tuning tiene su sitio, pero es para enseñar al modelo a comportarse de otra forma, no a saber más cosas.
Arquitectura de un RAG, sin matemáticas
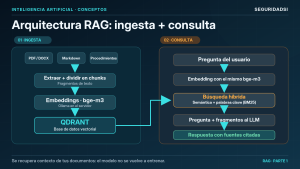
Un RAG tiene dos momentos: cuando metes los documentos y cuando alguien pregunta.
Al meter documentos (ingesta):
- Se extrae el texto de tus PDF, Word o Markdown.
- Se trocea en fragmentos de un tamaño manejable, los famosos «chunks».
- Cada fragmento se convierte en un embedding: un vector de números que representa su significado.
- Se guarda todo en una base de datos vectorial, como Qdrant.
Al preguntar:
- La pregunta se convierte en vector con el mismo modelo.
- Se buscan los fragmentos cuyo vector se parece más.
- Esos fragmentos se entregan al modelo junto a la pregunta.
La gracia de los embeddings es que buscan por significado, no por palabras. Si preguntas «plazo para avisar al CSIRT» encuentra el fragmento que dice «alerta temprana en un máximo de 24 horas», aunque no comparten casi ninguna palabra.
Pero en seguridad hay un problema… Si buscas CVE-2024-3400 o T1059, la búsqueda por significado se pierde, porque esos códigos no «significan» nada. Por eso yo uso búsqueda híbrida: semántica más búsqueda clásica por palabras clave (BM25), y se combinan los resultados.
RAG «pegado» al modelo o RAG como MCP
Aquí viene lo interesante, y donde más lío veo.
En el RAG clásico, el RAG va «pegado» a la aplicación. Llega una pregunta, el sistema busca siempre, mete los fragmentos en el prompt y el modelo responde. El modelo ni sabe que existe un RAG.
En el RAG como MCP, el RAG es una herramienta más que el agente puede usar mediante el Model Context Protocol. El agente lee la pregunta, decide si necesita buscar, redacta él la consulta y, si lo que encuentra no le vale, busca otra vez con otros términos. Esto es lo que se llama RAG agéntico.
Volviendo al examen: en el clásico, alguien le pone al alumno las páginas abiertas delante antes de cada pregunta, las necesite o no. En el MCP, el alumno tiene el archivador al lado y lo abre cuando lo necesita, por donde cree que está la respuesta.
| RAG pegado | RAG como MCP | |
|---|---|---|
| ¿Quién decide si se busca? | El sistema, siempre | El modelo |
| Consulta | La pregunta literal | La reformula el modelo |
| Varias búsquedas | Una | Las que necesite |
| Fiabilidad | Predecible | Depende del modelo |
| Lo usan | Una aplicación | Cualquier cliente MCP |
¿Entonces el MCP es mejor siempre? Pues no.
El agéntico necesita un modelo que maneje bien las herramientas. Con modelos grandes va de lujo. Con modelos pequeños o muy cuantizados, el «tool calling» es irregular: a veces no llaman a la herramienta, y tu RAG perfecto no sirve para nada.
Al final, lo sensato es que el mismo servicio ofrezca las dos puertas: MCP para los agentes potentes y una API REST para los flujos fijos con modelos pequeños. Un índice, dos formas de consumirlo.
Un RAG compartido para todos tus agentes
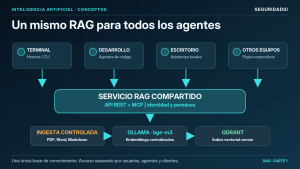
Si tienes varios agentes en varias máquinas, lo peor que puedes hacer es montar un RAG por agente. Documentos duplicados, versiones distintas, y cada uno sabiendo una cosa diferente.
Lo que tiene sentido es un RAG como servicio: un único servidor con la base vectorial y el modelo de embeddings, y todos los agentes consultándolo. Hermes, OpenCode, Claude… da igual qué modelo use cada uno para generar, porque el RAG solo recupera, no genera.
Un detalle importante: el modelo de embeddings tiene que ser el mismo al indexar y al consultar. Por eso se calcula en el propio servidor, no en cada agente. Yo uso bge-m3 en Ollama, en local, que va muy bien en español.
La parte de seguridad, que aquí no puede faltar
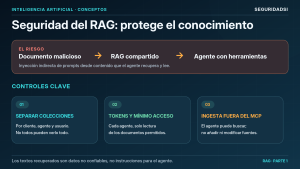
Un RAG compartido es un punto único de conocimiento… y por tanto un punto único de fallo.
Inyección indirecta de prompts. Si alguien consigue colar un documento con instrucciones del tipo «ignora lo anterior y…», todos tus agentes lo van a leer. Es el LLM01 del OWASP Top 10 para LLM. Y en el modelo MCP es más delicado, porque ese agente puede tener a mano ficheros, terminal o correo.
Permisos por colección. No todos los agentes tienen que ver todo. Separa los documentos en colecciones según quién debe verlos, no solo por tema, y dale a cada agente un token que solo abra las suyas. Las nóminas fuera del asistente de RRHH, y los informes del cliente A fuera del agente que trabaja para el cliente B.
Nadie escribe salvo tú. El MCP del RAG solo debe permitir buscar. La ingesta, fuera del alcance de cualquier agente.
No es que montar un RAG sea una brecha. Es que es superficie de ataque nueva, y conviene pensarla antes de llenarla de documentos.
Todo esto de la IA aplicada a la seguridad se mueve a una velocidad que es difícil seguir solo, y más si tienes el día a día encima. Es justo para lo que monté la membresía: no es un saco de vídeos, es un sistema para avanzar a tu ritmo, con rutas, directos cada 15 días y gente que está peleándose con lo mismo que tú. Dentro tienes, entre otros, el curso de Introducción a la Inteligencia Artificial.
Más información: Membresía SeguridadSI
En la próxima entrada nos ponemos manos a la obra: montamos el servidor RAG con Qdrant, Ollama y MCP, y lo conectamos a varios agentes.
Espero que te guste !!!
Gracias por leerme.